생성형 AI 모델을 고를 때 가장 먼저 비교하는 숫자는 보통 백만 토큰당 가격입니다. 그러나 기업이 실제로 원하는 것은 토큰이 아니라 해결된 문의, 정확한 분석, 검토를 통과한 문서 같은 결과입니다.
2026년 9월 11일 AWS와 OpenAI 관계자들은 Amazon Bedrock과 OpenAI API에서 여러 모델을 같은 하네스로 평가한 사례를 공개했습니다. 이 글의 핵심은 특정 모델의 순위보다, 실패와 재시도, 에이전트의 턴 수, 사람의 재작업을 포함해 비용을 계산해야 한다는 방법론에 있습니다.
3줄 핵심 요약
- 낮은 토큰 단가가 반드시 낮은 업무 비용을 뜻하지는 않으며, 정확도와 재시도 횟수까지 포함해야 합니다.
- 도구를 여러 번 호출하는 에이전트는 대화가 길어질수록 누적 입력과 지연이 커져 턴 효율이 중요한 비용 변수가 됩니다.
- 공개 벤치마크 순위를 그대로 적용하지 말고 실제 업무와 품질 기준으로 결과당 비용을 다시 측정해야 합니다.
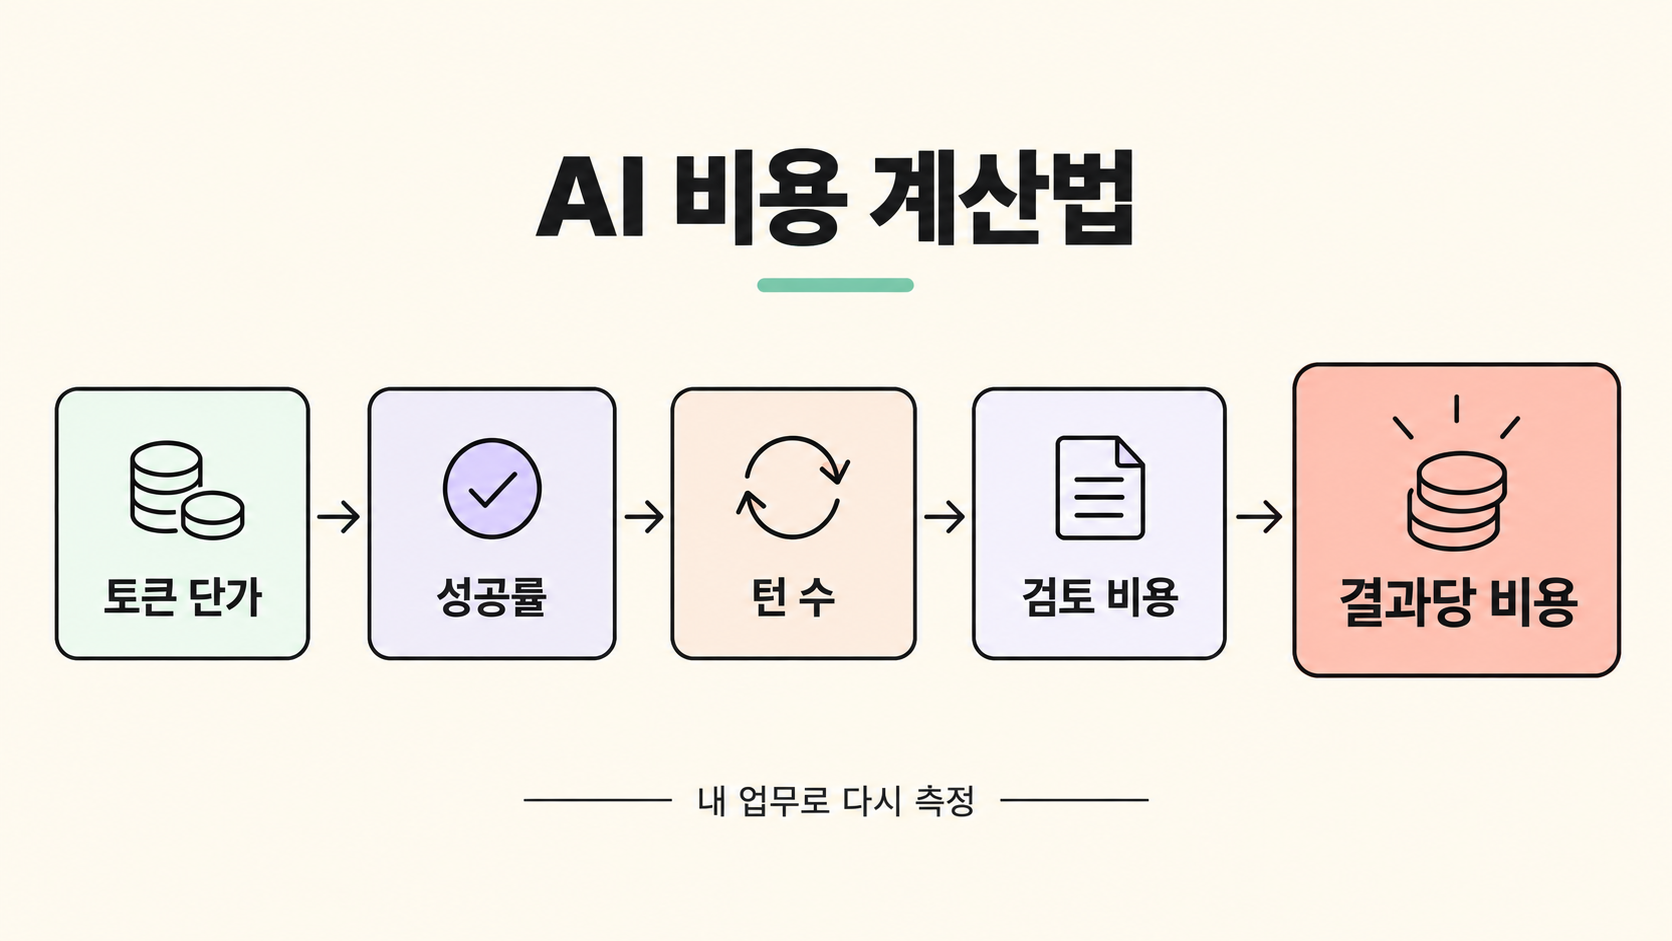
토큰 가격과 결과 가격은 다르다
모델이 한 번에 정확한 답을 내지 못하면 같은 업무를 다시 요청하거나 사람이 수정해야 합니다. 따라서 한 번 호출한 비용이 싸더라도 성공률이 낮으면 올바른 결과 하나를 얻는 총비용은 더 커질 수 있습니다.
AWS 글은 전체 시도 비용을 성공한 결과 수로 나눠 ‘정답당 비용’을 계산했습니다. 실무에서는 정답 대신 상담 해결, 분류 승인, 문서 검수 통과처럼 관찰 가능한 성공 조건을 먼저 정해야 같은 계산을 적용할 수 있습니다.
에이전트는 턴 수가 청구서를 바꾼다
검색과 도구 호출을 반복하는 에이전트는 단일 질문과 비용 구조가 다릅니다. 클라이언트가 매 턴 이전 대화와 도구 결과를 다시 보내는 구조라면 문맥이 계속 길어져 누적 입력 토큰이 빠르게 증가합니다.
더 저렴한 모델이 잘못된 검색을 반복하면 호출 횟수와 지연이 함께 늘 수 있습니다. 그래서 에이전트 비교에는 요청당 토큰뿐 아니라 성공까지 걸린 평균 턴 수, 도구 호출 수, 최종 통과율과 응답 시간을 함께 기록해야 합니다.
전문 문서는 문자열 정답으로 평가할 수 없다
보고서나 계획서처럼 답이 하나가 아닌 업무는 단순 일치율로 품질을 판단하기 어렵습니다. 공개 사례는 전문가가 만든 평가 기준에 따라 구조, 정확성, 주의사항과 완성도를 점수화하는 방식을 사용했습니다.
조직에서도 문서 유형별로 반드시 포함할 항목과 치명적인 누락 조건을 루브릭으로 정의할 수 있습니다. 모델 출력이 길이 제한에 걸렸는지, 사람이 어느 정도 수정했는지도 기록해야 실제 운영 비용을 비교할 수 있습니다.
작은 벤치마크 차이를 확정적 순위로 읽지 않기
AWS가 공개한 평가의 표본은 시험별로 48개에서 198개이며 일부 비교는 모델 설정도 동일하지 않습니다. 저자들은 작은 차이를 방향성으로 보고 고유한 모델 능력을 완전히 통제한 실험으로 해석하지 말라고 설명합니다.
특정 리전에서 측정한 지연이나 특정 날짜의 가격도 이후 그대로 유지된다는 보장이 없습니다. 결과표를 구매 결정의 답으로 사용하기보다 어떤 지표와 기록 방식이 필요한지를 참고하는 편이 안전합니다.
우리 업무로 결과당 비용 계산하기
먼저 실제 요청을 대표하는 50개에서 100개 정도의 작업과 사람이 확인한 기대 결과를 준비합니다. 각 모델에 같은 입력, 도구, 제한 시간과 평가 기준을 적용하고 성공률, 총 입력과 출력 토큰, 턴 수, 지연, 오류와 사람의 수정 시간을 기록합니다.
그다음 모델 사용료와 재시도 비용, 검토 인건비를 합쳐 통과한 결과 수로 나눕니다. 품질 하한을 충족한 후보끼리 비교해야 비용이 싸다는 이유로 업무에 쓸 수 없는 결과를 선택하는 오류를 피할 수 있습니다.
사용자와 업계에 미치는 영향
이 방식은 모델 선택을 가격표 비교에서 운영 성과 측정으로 바꿉니다. 고객지원팀은 해결된 티켓당 비용, 개발팀은 테스트를 통과한 변경당 비용, 콘텐츠팀은 검수 승인된 원고당 비용을 계산할 수 있습니다.
모델이 바뀌거나 가격이 조정돼도 동일한 평가 세트와 성공 기준을 유지하면 재검토가 쉬워집니다. 특히 에이전트형 시스템에서는 턴을 줄이는 프롬프트와 도구 설계가 더 싼 모델로 교체하는 것만큼 비용에 영향을 줄 수 있다는 점을 확인할 수 있습니다.
확인할 점
공개 글의 수치는 특정 시점, 리전, 모델 설정과 표본에서 나온 관찰값이며 다른 업무의 성능을 보장하지 않습니다. 일부 모델은 추론 기능을 끈 상태이고 비교 대상은 기본 설정을 사용해 고유 능력을 동일 조건에서 분리한 실험이 아닙니다.
LLM 평가자도 오판할 수 있으므로 중요한 샘플은 사람이 다시 검토해야 합니다. 실제 도입 전에는 최신 가격, 제공 리전, 데이터 처리 조건과 지연 요구사항을 공식 문서에서 다시 확인해야 합니다.
출처
'수수께끼연구소' 카테고리의 다른 글
| AI 에이전트에 GitHub 권한을 줄 때: OAuth 동의 설계 5가지 (0) | 2026.09.15 |
|---|---|
| 이번 주 AWS 핵심 4가지: GPT-6 Astra부터 90분 Lambda까지 (0) | 2026.09.15 |
| AI가 만든 코드를 믿기 전 확인할 3가지: 변경·실행·화면 (0) | 2026.09.14 |
| AI 에이전트가 멀쩡해 보여도 실패한다: 운영 모니터링의 두 축 (0) | 2026.09.13 |
| 반복 업무를 코드처럼 관리하는 법: GitHub가 공개한 자동화 설계 5가지 (0) | 2026.09.13 |