웹사이트 운영자는 검색엔진에는 콘텐츠를 보여주고 싶지만 같은 자료가 AI 모델 학습에 사용되는 것은 원하지 않을 수 있습니다. 문제는 일부 사업자가 검색과 학습에 같은 크롤러를 사용해 한쪽만 차단하기 어렵다는 점입니다.
Cloudflare는 2026년 9월 15일 검색 노출을 유지하면서 AI 학습 거부 선호를 전달하는 ‘Disallow AI Training’ 설정을 발표했습니다. 이번 변화는 단순한 봇 차단보다 콘텐츠의 사용 목적을 구분하는 방향으로 웹 제어가 이동하고 있음을 보여줍니다.
3줄 핵심 요약
- 검색과 AI 학습을 한 크롤러가 함께 수행하면 사이트 운영자는 노출과 학습 거부 사이에서 선택해야 하는 문제가 생깁니다.
- Cloudflare는 검색 접근은 유지하면서 robots.txt에 학습 거부 선호를 게시하는 새 설정을 공개했습니다.
- robots.txt는 의사 표시일 뿐 강제 수단이 아니므로 크롤러 식별, 실제 차단과 투명한 보고가 함께 필요합니다.
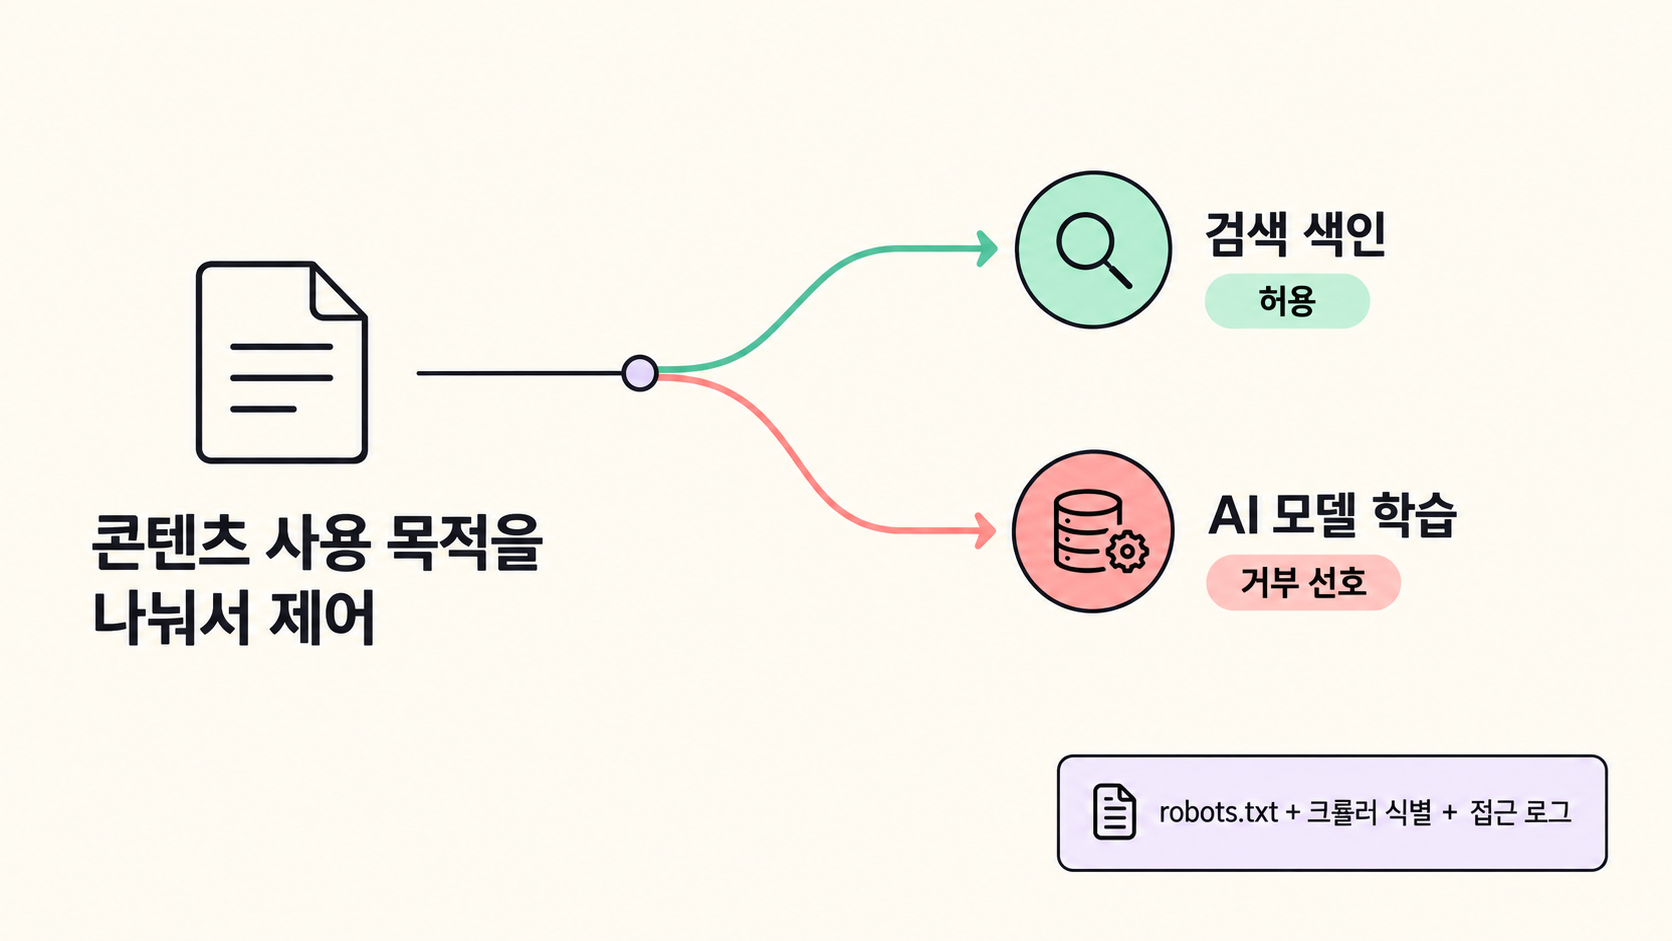
검색과 학습을 한 번에 막는 문제
전통적인 검색 크롤러는 페이지를 색인해 사용자를 사이트로 연결합니다. AI 학습 크롤러는 콘텐츠를 모델 훈련이나 미세 조정에 사용할 수 있어 목적과 사업 영향이 다릅니다.
하지만 하나의 크롤러가 두 역할을 수행하면 접근을 허용할 때 학습까지 허용되고, 막으면 검색 노출도 잃을 수 있습니다. Cloudflare는 이를 혼합 용도 크롤러 문제로 설명하며 검색, 학습, 사용자 요청형 에이전트를 별도 행동으로 분류했습니다.
Disallow AI Training은 무엇을 바꾸나
새 설정은 사이트의 robots. txt에 학습 거부 선호를 게시하면서, 해당 선호를 존중한다고 확인된 혼합 용도 크롤러의 검색 접근은 유지합니다.
그 밖의 학습 전용 크롤러는 차단하는 방식입니다. 반대로 ‘Block’을 선택하면 혼합 용도 크롤러도 완전히 막혀 검색 색인에 영향을 줄 수 있습니다.
사이트 관리자는 단순히 AI 봇을 막는다는 표현보다 검색, 학습, 에이전트 중 어떤 행동을 허용할지 구체적으로 결정해야 합니다.
robots.txt만으로는 강제할 수 없다
robots. txt는 크롤러 운영자에게 사이트의 선호를 알리는 공개 규칙이지만 이를 무시하는 주체를 기술적으로 멈추지는 못합니다.
요청을 보낸 봇이 누구인지와 실제 목적이 무엇인지도 파일 하나만으로 확인하기 어렵습니다. Cloudflare는 네트워크에서 크롤러를 식별하고 선언된 행동과 정책 준수 여부를 분류하며, 거부 선호를 따르지 않는 학습 크롤러를 차단한다고 설명합니다.
운영자는 설정을 켜는 것과 함께 접근 로그와 검색 색인 변화를 계속 관찰해야 합니다.
검색 노출과 AI 요약은 별개의 문제
학습을 거부해도 검색 결과의 AI 요약에 콘텐츠가 얼마나 표시되는지는 별도의 문제입니다. 요약이 원문 방문을 줄일 수 있는 반면 구매 의도가 높은 방문자를 보낼 가능성도 있어 사이트 유형마다 이해관계가 다릅니다.
광고 기반 매체는 방문량을, 쇼핑몰은 전환율을 더 중요하게 볼 수 있습니다. Cloudflare는 향후 요약 포함량을 더 세밀하게 제어하는 기능을 목표로 제시했지만 현재 제공 기능과 향후 계획을 구분해서 봐야 합니다.
사이트 운영자가 확인할 체크리스트
먼저 현재 robots. txt와 CDN 또는 보안 서비스의 봇 설정을 백업하고 검색, 학습, 에이전트별 정책을 문서화해야 합니다.
변경 뒤에는 주요 검색엔진의 색인 상태, 검색 유입, 학습 크롤러 접근과 오탐 차단을 비교합니다. 일부 운영자의 지원은 즉시가 아니라 약속된 일정에 따라 제공될 수 있으므로 각 크롤러의 공식 문서도 확인해야 합니다.
검색 트래픽에 의존하는 사이트라면 전체 차단을 바로 적용하기보다 작은 도메인이나 테스트 구간에서 영향을 검증하는 편이 안전합니다.
사용자와 업계에 미치는 영향
이번 설정은 웹 콘텐츠 제어를 ‘허용 또는 차단’에서 ‘목적별 허용’으로 세분화합니다. 출판사와 블로그 운영자는 검색 유입을 포기하지 않고 학습 거부 의사를 표현할 수 있고, 크롤러 운영자는 검색 순위와 학습 선택을 분리했다는 점을 더 투명하게 보여줘야 합니다.
장기적으로는 AI 요약, 에이전트 접근과 학습을 서로 다른 정책으로 다루는 표준이 중요해질 가능성이 큽니다. 사이트 운영자는 트래픽 양뿐 아니라 원문 방문, 전환과 콘텐츠 사용 방식까지 함께 측정해야 합니다.
확인할 점
이 기능은 Cloudflare의 크롤러 분류와 정책 집행을 기반으로 하며 모든 웹 호스팅 환경에 자동으로 적용되는 인터넷 표준은 아닙니다. robots.
txt의 거부 선호는 이를 존중하는 운영자에게만 의미가 있고 악성 또는 식별되지 않은 봇을 단독으로 막지 못합니다. Apple, Google, Microsoft의 지원 범위와 일정은 서로 다르며 일부 기능은 향후 제공 약속에 해당합니다.
설정 변경 전 최신 공식 문서와 검색엔진별 지침을 확인하고 검색 노출이 중요한 사이트에서는 색인 변화를 모니터링해야 합니다.
출처
'수수께끼연구소' 카테고리의 다른 글
| AWS 가입부터 비용 관리까지 쉬워진다? 새 시작 화면에서 꼭 확인할 5가지 (0) | 2026.09.17 |
|---|---|
| AI 에이전트·CI에 운영 권한 줄 때 지켜야 할 최소 권한 원칙 (0) | 2026.09.16 |
| AI 에이전트에 GitHub 권한을 줄 때: OAuth 동의 설계 5가지 (0) | 2026.09.15 |
| 이번 주 AWS 핵심 4가지: GPT-6 Astra부터 90분 Lambda까지 (0) | 2026.09.15 |
| AI 모델 비용, 토큰 단가만 보면 틀린다: 결과당 비용 계산법 (0) | 2026.09.14 |